vchiha’s diary

朝活でデータ関係の勉強とランニングをしてます

顧客の解約を予測せよ|統計知識で6指標を検定 前編

0. リード + 結論の表

「解約しそうな顧客を、事前に予測できないか」

BtoB SaaS の会社で、そういう仕組みを作っています。解約は増えているのに、どういう顧客が解約するのかを、社内の誰もデータで説明できませんでした。

最初に顧客の属性(業種・契約規模・決算月)を片っ端から調べてみましたが、全部外しました。

そこから、現場への聞き方を変えて指標を見つけ、統計検定で絞り込むまでの話です。結論だけ先に書くと、こうなります。

課題の答えを聞くのではなく、相手が確実に答えられることを聞く。

Before 解約が増えたが、どういう顧客が解約するのかを誰もデータで示せなかった
投下時間 統計検定3級 73.5時間 + Python3データ分析試験 約30時間
After 指標が4つに絞れた。うち先に運用に乗せた1つが、実運用で 的中率20%・再現率70%。そのうえで検定を回し、無作為の約10%に対して 18.8%/19.05% の指標を2つ積み増した
次に見えた課題 指標は決まった。でも、統計で答えが出ることと、現場が動くことは別だった

後編では、ここから統計検定2級取得~ロジスティック回帰に進みます。


1節. 使う人が減り始めた。でも理由は誰も言えなかった

BtoB の月額課金サービスを売っている会社です。単価 × 利用ユーザー数で売上が決まる。1ユーザー分の契約を、社内では「ID」と呼びます。

使う人が減れば、そのまま売上が落ちる。

ある四半期、そのID数が純減しました。想定を超える量です。

解約は2種類。契約が丸ごと無くなる完全解約と、「50人で使っていたけど来期は30人に」という部分的な縮小。多いのは後者で、しかも静かに起きます。気づいたときには、もう決まっている。

解約しそうな企業を、事前に検知できないか。

声は集まっていた

顧客と接している部署には、情報が山ほどありました。「他社ツールを検討しているらしい」「操作を覚える時間がないと言われた」。理由の候補は豊富です。

足りないのは、その先でした。

「じゃあ、どの数字がどう動いたら危ないのか」を決める工程が、どこにも無い。

「検討しているらしい」は誰かの頭の中にある情報で、何千社に一度には当てられません。一社ずつ電話で確かめるわけにもいかない。

声を、ログに残る数字に翻訳する。 そこが、今回の仕事でした。

結果から言うと、翻訳のやり方を3回変えています。候補の出どころが、毎回違います。

候補をどこから出したか 結果
1回目 会社の属性(業種・規模・金額・決算月) 4つ試して、4つとも外し
2回目 現場の勘(毎日顧客と話す人に聞く) 2つ出して、1つ当たり
3回目 統計検定(6つまとめて検定にかける) 2つ採用、4つ棄却

以下、この順に書きます。


2節. 【1回目】顧客の属性で総当たりして、全部外しました

解約した企業と、していない企業を並べて、何が違うかを探す。そう考えました。

ところが、その「並べる」が最初の壁です。

  • データが複数のシステムに分かれている
  • つなぐキーがシステムごとにバラバラ
  • 集計期間も、見る属性も、閾値も、全部こちらで決めていい

3つ目がきつい。「全部決めていい」は、正解が無いということ。何を仮説と呼ぶのかも、このときは分かっていませんでした。

人事にいた頃も採用候補者のデータは触っていました。ただ、量もデータの種類もまたがるシステムの数も桁が違う。腰を据えた分析は、これが初めてです。

それでも手元にあるもので切ってみます。

切り口 なぜ試したか 結果
業種 顧客マスタに最初から入っている項目だから 業種で分けても、解約率が偏らない
契約規模(ID数) 同上 規模で分けても法則が出ない
契約金額・単価 同上 金額の高低と解約に関係が見えない
決算月 雑談で出た話から 決算月でグループ分けしても、解約率に差が出ない

上の3つは仮説というより総当たり。手元の項目を順に当てただけで、理屈はありません。

決算月だけ毛色が違います。きっかけは雑談でした。

「やっぱり決算月で解約するのかな」 「というか、カスタマーサクセスも営業も、相手の決算月を意識して動けてないよね」

立派な仮説ではない。「調べる価値はありそう」くらいです。

4つ試して、4つとも外れました。 スプレッドシートを11ファイル作って、グラフも並べた。でも何も出ない。3月に手をつけて、人前に出せたのは5月の連休前。当時のメモに残っているのは「分析はカオス」の一行だけです。

決算月には、もう少し踏み込んだメモがありました。

決算月を入れてみたけど、決算月クラスタでの解約傾向の違いはない。案件単位で判定されていそう。

「会社の属性」ではなく「案件の動き」で決まっているのではないか。確信ではありませんが、方向は出ていました。

※ここでいう「案件」は商談のことではなく、顧客が自分の仕事を区切る単位です。1つ仕事で1案件。


3節. 【2回目】人に聞いた。「どう振る舞いますか?」

とはいえ、「案件の動き」と言ってもまだ当てずっぽうです。どの動きを見ればいいのかが決まらない。

データだけ見ていても出ないので、カスタマーサクセスに聞きに行きました。

「解約しそうな会社って、どういう感じなんですか」 「他社のアプリも一緒に検討し始めてるときが多いですね」

なるほど。でも、これは測れません。「検討している」は誰かの頭の中にある話で、ログには残らない。

なので、もう一段聞きました。

「では他社アプリを使っている場合、ユーザーはどのような行動をとります?」

返ってきた答えが、具体的でした。

「複数の案件で併用し始めるはず。この案件は自社のサービス、あの案件は他社のアプリ。という使い方になる」

これなら測れます。2つに分解しました。

  • ① ログインする人が減るはず
  • ② 自社サービス内で作られる案件が減るはず

聞き方を変えたのが大きかった

私は、「予兆は何だと思いますか」とは聞いていません。

聞いていたら、たぶん答えは返ってきませんでした。実際この1ヶ月後、同じ趣旨のアンケートを全体に出して、ほぼ回答が集まりません。(上長からチーム全体に依頼してもらった上で、です)

「危ない予兆は何か」は仮説です。仮説を立てるのは分析する側の仕事で、現場に聞くことではない。

一方「他社アプリを使っている人がどう振る舞うか」は、毎日見ていること。だから確実に答えが返ってきます。

課題の答えを聞くのではなく、相手が確実に答えられるものを聞く。 課題を見つけて、全体の中での重みを考えて解くのは、こちらの仕事です。


4節. ①を3回検証して、3回とも外しました

対象は、他社ツールを併用していると社内で把握できていた4社です。

1回目:会社ごとのログイン回数

監査ログから「日単位のログイン有無」を集計。同じ日に何回ログインしても1カウント、月に20日なら20。これを四半期ごとに出し、全社の合計 ÷ ID数と、併用4社の値を比べました。

差なし。

2回目:ユーザー単位の分布

合計で分からないなら、分布はどうか。四半期内に何日ログインしたかを、1人ずつ数えました。

四半期内のログイン日数 全社 併用4社
1〜10日(あまり使わない層) 45.15% 39.35%
11〜30日 28.05% 26.43%
31日以上(よく使う層) 23.74% 30.05%

逆でした。 併用している側のほうが、「あまり使わない層」が5.8ポイント少なく、「よく使う層」が6.3ポイント多い。

3回目:また聞きに行く

数字で出ないので、また聞きました。

「毎日ログインするものでもないですよ。案件の進み方に合わせて、資料を登録したり記録を残したりするので」

※案件の箱には、資料Aと資料Bの2種類を入れます。資料Aは案件の土台になるもので、これが無いと始まりません。資料Bは作業の中で記録していくものです。

これで①は終わりです。3回やって3回とも外し。「他社ツールを使っている=自社サービスを使わなくなる」という私の先入観が、そもそも間違っていました。データに聞く前に、自分の思い込みに聞いていたわけですw

そして、ここには穴があります

併用4社のユーザー数は、全社のおよそ0.3%。この規模差で「45.15%と39.35%」を並べて、私は「目立った差は見られない」と書きました。

差が無いのか、サンプルが小さすぎて判断できないのか、区別していません。

この穴に気づけるのは、2ヶ月後です。


5節. ②が当たりました

そして②。会社ごとに、月ごとの案件の作成数を出しました。

前提を3つ置いています。業界全体の市場規模は一定 / 自社の顧客数はむしろ増加傾向 / 顧客のなかの案件数も全体では増えている。全体が増えている中で減っているなら、意味があります。

結果は、4社のうち3社で、昨年比の案件作成数が減少。月単位ではばらつきますが、年でまとめると明確に減少方向でした。

ログインは横ばいなのに、新しく作られる案件だけが減っている。

  • 既存の案件:引き続き自社で運用(だからログインは減らない)
  • 新しい案件:他社ツールで試している(だから作成数が減る)

「使わなくなる」のではなく「新しい仕事から順に、別のツールへ移っていく」。乗り換えではなく、使い分けです。

離反の初期兆候は、ログインより先に「案件作成の落ち込み」に表れる。

この形で実装しました。

(直近3ヶ月の月平均)÷(4〜15ヶ月前の月平均)< 0.7(=30%以上の減少)

15ヶ月分を使うのは、昨年の同じ時期を分母に含めるためです。案件には季節の波があるので、直近3ヶ月だけを見ても意味がありません。


6節. 【3回目】検定という道具を手に入れました

指標は1つ決まりました。でも「他にもあるんじゃないか」が残ります。それを確かめる方法を、私は持っていませんでした。

4節の穴がそれです。「差が無いのか、サンプルが足りないのか」を区別できない。2節の11ファイルも同じ。2ヶ月かけて、結論が出せない。

Python とクラウドの勉強は続けていました。

ehrsp1.hatenablog.com

データを集めて、溜めて、取り出すところまでは、だいぶできる。でも、取り出したあとが分からない。

どう加工すれば比べられるのか。どう見れば「違いがある」と言っていいのか。集計はできる。でも分析ができない。 自分に何が足りないのかも言葉にできなくて、かなり苦しかったです。いちばん中途半端なところにいましたね。

調べていくうちに「統計検定」に行き当たりました。足りないのはこれだと思いました。

ehrsp1.hatenablog.com

統計知識に加え、Pythonももっと使いこなしたい。

ehrsp1.hatenablog.com

合わせて約100時間(もっとかも)。どちらも、この業務の途中で必要になって取ったものです。

そこで仮説検定を知りました。偶然のばらつきかどうかを、数学的に判定できる。

判定の基準を先に決める

母集団は、一定規模以上の契約をしている顧客。このうち、ある四半期に10%以上の解約が起きた企業は 10.49%。無作為に選んでも10.49%は当たる。これが基準です。

そこから二項分布で、どこから「偶然ではない」と言えるかを計算しました。当時のメモです。

抽出企業数にもよるが19%以上で、めちゃ優位(二項分布)

「抽出企業数にもよるが」が大事なところ。何社拾えるかで必要な水準は動くので、19%は固定の線ではなく目安です。

比べ方も2通り。直前の四半期と比べるか、昨年の同じ時期と比べるか。

6つの指標を検定して、残ったのは2つ

仮説は6つ。残ったのは2つだけでした。

残った指標 四半期と比べて 昨年と比べて
資料Aの操作数が30%以上減 18.8% 22% ✅ 採用
資料Bの割合が85%以上 19.05% 17% ✅ 採用

「資料Bの割合」は 資料B ÷(資料A + 資料B) です。土台である資料Aをあまり使わず、資料Bに偏っていると高くなります。無作為なら10.49%のところ、どちらも19%前後。基準を超えました。

落ちた4つには、こんな理由が並んでいます。「解約と関係なく減少する企業がある」「ログインしていなくても解約しない企業がある」「減少と上昇が混在している」。

そして、残った2つも、効く比べ方が逆でした。資料Aは昨年と比べたほうが強い(22%)。資料Bの割合は直前の四半期と比べたほうが強い(19.05%)。

変化を見るべき指標と、いまの水準を見るべき指標が、別々にある。

落ちた4つのうち1つは、資料Bの「数」でした。割合なら採用、数なら棄却。同じものを見ているのに、結果が分かれています。

資料Bを何枚作るかは、会社ごとの癖です。たくさん作る会社もあれば、ほとんど作らない会社もある。数で比べると、その癖に埋もれる。割合にすると癖が消えて、変化だけが残る。

2ヶ月前の自分に、答えが出せます

4節で私は「差が無いのか、サンプルが小さすぎるのか区別していない」と書きました。いま同じ問いを投げれば、答えが出ます。

統計知識が無いときは、例えば「10%」「30%」という数字の差分を見て「差はないかも」としか言えない。知識があれば「この差は偶然では説明がつかない」と言えます。

同じデータです。変わったのは、分析している人の能力だけ。


7節. 「これ凄いね」と言われました。でも

これで、アラートは2系統になりました。

中身 いつから
1系統目 5節の案件作成数が30%減 すでに半年ほど運用中
2系統目 6節の検定に残った2つ 次の四半期から追加

先に実績が出たのは、1系統目のほうです。以下はその数字です。

対象は、カスタマーサクセス。そこへ「この企業を見てください」を出す仕組みです。

対象企業の解約率(担当が付かない層) 11.1%
アラートを出した企業の的中率 20%
実際に解約した企業のうち、拾えた割合 70%

7割は取りこぼさない。粗い数字ですが、兆しは見えたと思いました。

カスタマーサクセスの定例に出させてもらって、目的と背景、そしてダッシュボードを見せました。その会議の最中に、同席していた執行役員からこう言われます。

「これ凄いね。みんなこれ見て動けばいいじゃん」

それでも、現場には浸透しませんでした

半年後に運用記録を見返すと、アラートが出た企業に接点がとられていません。記録に並ぶのは「以前顧客担当者と会話済み」「別ルートで接点があるため今は動かない」「(アラートがあっても)解約リスクは感じられないため」。確認済みのチェックは、ごく一部。

サボっていたわけではありません。みんな、もっと確かなものを持っていました。

営業とカスタマーサクセスの間で、すでに共通認識になっている会社。顧客から直接言われたことを整理して、どう話を進めるのか、どう対策するかを考えながら決めています。

データで行動が決まる、という動き方ではありませんでした。

要望も出ます。

個社ごとに見たい。

アラートは「全体から危ない会社を抜き出す」道具です。担当者が知りたいのは「自分が見ている会社が、いまどうなっているか」。単位が逆でした。

1節に書いたとおり、声はもともと集まっていたんです。私はそれを「何千社に一度には当てられない」から数字に翻訳しました。でも担当者は、自分が見ている会社の声を、はじめから持っている。翻訳したものを渡しても、増える情報がありません。

3節では、聞き方を変えて指標を見つけました。なのに作ったものの使われ方では、同じズレをもう一度やっています。相手が何を知りたいかを、聞いていませんでした。

仕組みは動いていました。動いていなかったのは、その先です。


8節. 外した企業を、1社ずつ調べました

的中率20%ということは、残りの8割は外しています。仮に10社に接触しても、8社は外す。そりゃ現場も動きませんよね。

アラートが出たのに解約しなかった企業を、他部署に協力してもらって1社ずつ聞きました。フリーテキストで集めて分類すると、原因は2つ。

  1. 指標が価値の代わりにならない — 少ない案件でも、案件内でかなり使いこなしている
  2. 比較の基準が歪む — 定期的に案件が作られるわけではない。個社ごとにバラバラ

一番多かったのは、これです。

「これから使い始める企業」が、全体の3分の1。

案件が少ないのではなく、これから使いこなしていく顧客でした。向きが逆です。

単独の指標では的中率は上がらない。複数を同時に見るしかない。


9節. 統計で答えが出ても、すぐに結果にはなりません

ここまでが、統計検定3級とPython3データ分析試験で学んだことを、実際の業務に当てた最初の仕事でした。

やってみて、はっきりしたことがあります。

統計的に証明できることと、現場でどう使うかの間には、確実に穴がある。

二項分布で「偶然では説明がつかない」と言えても、それだけでは誰も動きません。7節のとおり執行役員が「これ凄いね」と言っても足りない。

統計で答えが出たからといって、いきなり結果が付いてくるわけではありませんでした。

結局、カスタマーサクセスとの解約予測は、いったん終わりになりました。「営業と共通認識が取れているやり方のほうがいい」と言われています。そのとおりだと思います。

組み直した先は、顧客接点を持たない部署でした。顧客の声が入ってこない。でも見る会社は多い。

7節の裏返しです。声を持っている人には、データが要らなかった。声を持てない人には、データしかない。

理論と、現場がどう動くかの感覚。両輪が回らないと、何も変わらない。それが、この1年で一番こたえた学びです。

それでも、変わったことはあります

「なんかこれが原因かもね」で止まっていた話が、

「確かにね。やっぱりね。てことは、こうやって動いてみようかな」

に変わりました。

誰もデータで説明できなかったことに、初めて根拠がついた。そこまでは、確かに動きました。

残っているのは、的中率です。10社に接触して8社が見当違いなら、どう説明しても現場は動けません。

そこを、次はモデルで越えられないか。

ここから、ロジスティック回帰に進みます。統計検定2級を取ったのは、この直後でした。

続きは後編で。
TOEIC学習記録3

TOEIC 530点。打ち手を3回外して、課題の数え方を変えた

TOEICの記事はこれで3本目です。

先に書いておくと、今回は点数が上がった話ではありません。むしろ、3回続けて打ち手を外していた回です。しかも、外し続けた原因は打ち手のほうではありませんでした。悲しくなりますが、振り返りは振り返り。そういう回もあると割り切って書きます。

続きを読む

筋トレ9週間やってみた

体重が増えている。

2025年は年間1,053km走ったのに、2026年に入ってランニング量を減らしたら体重がじわじわ上がってきました。「走らないとこうなるのか」と危機感を覚えたのが5月。じゃあ筋トレを始めよう、と朝活にジム通いを追加しました。

ただ、やるだけだと続かないのは分かっていたので、最初から測ることにしました。測ったのは3つです。

  • 週次: 目標分数と実績分数(週報に記録)
  • 毎朝: 体重と体脂率(体組成計)
  • 毎回: 種目ごとの重量×回数×セット(ジムアプリ)

9週間で56回体重を測り、投下時間はおよそ18〜27時間。数字が何を教えてくれたかの記録です。


計画は初週で崩れた

初週の目標は150分。実績は90分でした。

やる気があったので詰め込もうとしたのですが、筋肉痛がかなり長引いて動けなくなりました。結果、間隔が空きました。

そこからは徐々に、体が慣れるにつれて頻度が上がりました。プロテインも飲み始めました。

やる気ではなく、筋肉痛の回復速度のほうが頻度を決めますね。

そしてペースが上がってきた6月、週の目標を150分から180分に上げました。

「前回以上」だけで伸びる

ジムアプリは前回の重さ・回数・セット数を出してくれます。やっていたのは、それを上回ることだけです。

種目 5/3 7/3 変化
ベンチプレス 50kg×10 70kg×10 +40%
レッグプレス 40kg×10 79kg×10 +98%
ラテラルレイズ 12kg×10 18kg×15 重量+50%・回数+50%

6月から記録を始めたシーテッドロウ、トライセップス、インクラインプレスも1ヶ月で+18〜30%。約20時間の投下でこれなら、悪くない効率だと思います。

前回の数字を見て、同じか少し増やすだけを繰り返してたら勝手に上がっていきました。

日曜の11時にジムへ行ったら人が多くて、待ち時間で予定が崩れて諦めた日もありました。以来「休日は絶対に早朝」と決めました。

負荷は上がったのに、体組成は動かない

一方、体組成のほうは9週間でこれだけでした。

指標 9週間の変化
体重 -0.2kg
体脂率 -0.13pt
筋肉率 +0.10pt

扱う重量は40〜98%増えているのに、体組成はまったく動いていません。妙だなと思っています。

2ヶ月では変わらないものなのか、測り方の問題なのか。判断できる材料がまだないので様子見です。


そして、7週間止まりました

6/29週、ベンチプレスが70kgに到達しました。5月の50kgから+40%です。

その同じ週に、肋間神経痛を発症。激痛で筋トレとランニングができなくなりました。

週 実績
7/6 ~ 8/24 0分

筋トレの負荷で「前回以上」は目標設計として良いですが、上限がありません。上げ続けた先に限界が来るのは当たり前で、やりすぎたようです。

8/27、久しぶりに測った

約1.5ヶ月以上ジムに行っていない状態で、体重と体脂率を測りました。

ほとんど変わっていませんでした。 体重はわずかに増、体脂率もわずかに増。


学んだこと

前回の数字が見えるだけで伸ばしやすい。ただし「前回以上」に上限を決めなかったのが故障の原因と考えています。

もちろん記録しながらですが、違和感を感じたらストップ・調整します。常に限界まで挑戦するのでなく、継続性を意識して進めます。

簿記3級受験しました


データ分析の業務でも、社内の共有資料でも、財務諸表は普通に出てきます。ある程度は理解している。でも理解度をもうちょっと上げたくて、お盆休みのまとまった時間を当て、簿記を勉強しました。

結果、経理経験ゼロでしたが、4週間・108時間積み上げ93点合格 🎉

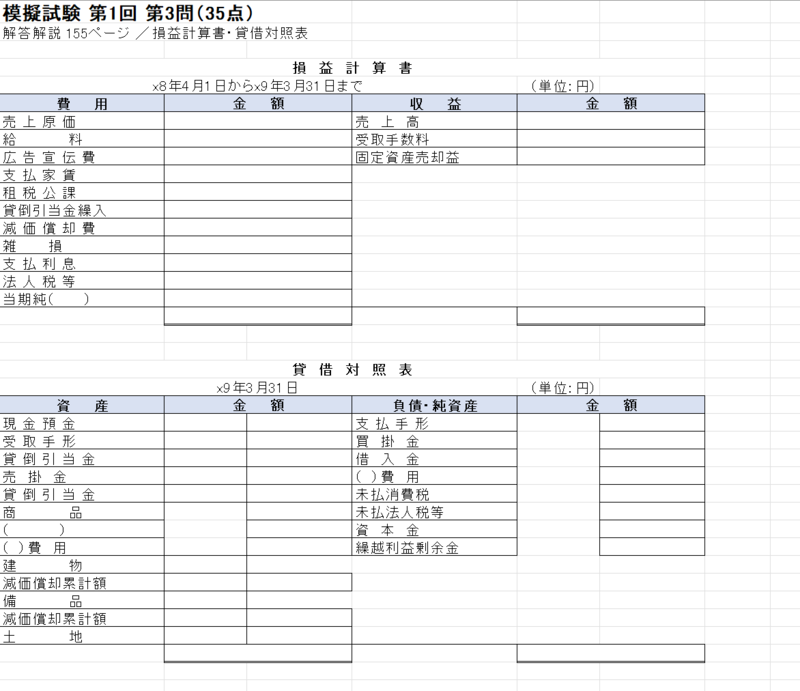
Pythonが生成したExcel答案用紙

今回、先月GCP ACEで作った学習プロセスを、教材だけ差し替えてそのまま使いました。

ehrsp1.hatenablog.com

続きを読む

AppSheetをやめてCloud Run+GitHubアプリ制作

将来的にスピード感を持って開発をしたい、あとGoogle Cloud(GCP)ももっと活用したい。

でも、資格取得で知識はついてきたが、実際のGitHub運用やGCPインフラの構築経験は無い。

そこで「実務で必要になってから」ではなく、まずは個人開発で挑戦してみることにしました。

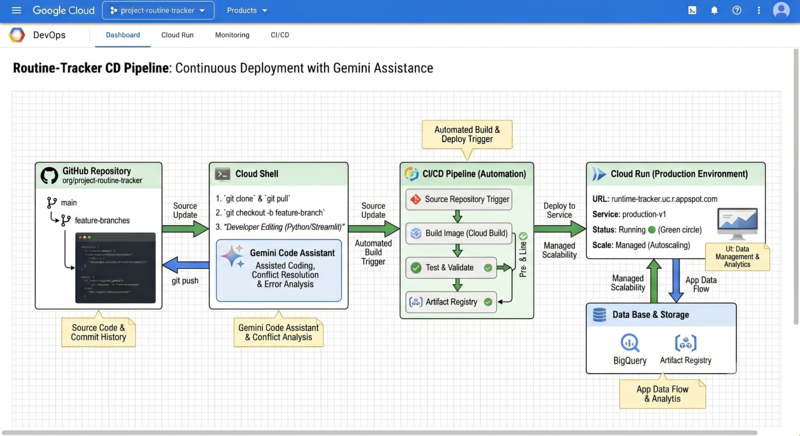
最終的に作ったシステム構成図


1. 背景:行動管理ツールの課題と、技術習得の必要性

朝活スケジュールや学習進捗管理については、一年ごとに変化。

  • 2023年は特に管理なし
  • 2024年はスプレッドシート
  • 2025年からAppSheetとLooker Studioの組み合わせ

少しずつ便利にしてきました。

ehrsp1.hatenablog.com

ただ、AppSheetでも結局はデータソースがGoogleスプレッドシートなので、以下2つは懸念。

  1. データ蓄積の限界:なんとなくイケてない。

  2. 画面構成の制約:LookerStudio上のカスタマイズに限界があり、「入力したその場で、同一画面でグラフを表示したい」といった細かい要望に応えきれない。AppSheetで入力した後にLooker Studioを開いて確認する、という2ステップが手間に感じる。

「実務経験を積みたい」という自身の課題。 「ツールの限界」という運用の課題。

この2つから「勉強を兼ねてアプリを作っちゃえ!」と決意。

Cloud Run、GitHub、BigQueryを組み合わせたWebアプリケーション(Routine-Trackerと命名)を構築することにしました。


2. 目標とタスク:未知のインフラへのアプローチとマニュアル化

プロジェクトの具体的な目標とマイルストーンを以下のように設定しました。

  • 期間:2月上旬〜4月下旬(約2.5ヶ月)

  • 技術的な目標:

    1. GitHubとCloud Runの連携によるCI/CD(自動デプロイ)環境の構築
    2. 言語はPython(結果的にははStreamlitを用いてUIUXも含めて実装)
  • その他:「作った⇒だから覚えた」とするのも雑。「何をもって習得したか」をひとまず、GitHubの開発手順をドキュメント化(仕組み化)することを覚えたという基準としました。


3. 行動:エラーの構造化と、環境変化を活かした開発

いきなりGitHub連携を目指すと挫折しそうなので、ネットにある「ローカル環境からの直接デプロイ」(Cloud Ace社の解説記事)を正確に再現するところから開始。

手元での動作を確認した後、GitHub連携にするようにして、少しずつ覚えました。

ソースコードは簡単でしたが、ローカル環境からのデプロイとGitHub連携をするのに8時間(505分)かかりました。

🛠️ 運用安定化のために作成した「GitHub開発サイクルマニュアル」

その後、作りたいアプリ開発へ。

GitHubに入れられたんですが、やはり苦戦。2度目のプルリクエスト(PR)時に最新のmainブランチとのコンフリクトが発生し、大混乱。

何とか修復し、以下のように手順をGoogleドキュメントに入れて、二度と間違えないように作業開始前のルーティンとしました。

GitHubの本も1年前に読んだんですが、実際使って自分で失敗しないとわからないですね。^^;

ステップ 実行コマンド 目的・導入背景
1. 現在地の確認 git branch どのブランチを作業中か確認し、前日の残り作業の有無を把握する。
2. リモートの確認 git fetch origin 自分が作業していない間にGitHub側が更新されていないかをチェックする。
3. mainの最新化 git checkout main
git pull origin main
土台となる本番環境のブランチを常に最新状態に更新する。
4. 作業枝の作成 git checkout -b feature-日付 本番環境に影響を与えないよう、その日の作業専用ブランチを切り出す。

実際はブランチ作らなくても私しか作る人いないので意味がないんですが、動作を覚えるためにやりました。

開発途中で、Gemini Code Assistantを使ってみたらこれが便利で、「動作確認 ⇒ 修正点の言語化 ⇒ 修正前後のソースコード比較」のプロセスを効率化。

こんな感じで積み上げた合計開発時間は約50時間(2500分)に達しましたが、無事全4画面の実装、テスト、UIの微調整を一気に完了させることができました。


4. 成果:リアルタイム化の実現とインフラコストの可視化

移行完了後、これまでのAppSheetと新アプリを並行稼働させてデータ検証と利便性の比較を行いました。

  • 業務効率の向上: これまでは「AppSheetで入力」⇒「Looker Studioへ移動して確認(データ反映にラグあり)」という2ステップ、15秒が必要でした。新システムでは、入力と同時に同じ画面の下部で進捗グラフがリアルタイムに更新される仕組みなのでその分効率化。だいたい一日5回は入力・進捗確認をするので、1日75秒の削減。

  • スマホ環境の最適化: ブラウザで軽快に動作するWebアプリ(PWA対応)へ移行したことで、ネイティブアプリのインストールが不要となり、端末管理の手間を省きました。

  • コストとベネフィットの定量評価: 5月上旬のGoogle Cloudからの請求額は800円/月でした。以前構築した単純な天気予報アプリ(30〜40円/月)と比較してコストは上昇しました。

「AppSheet(無料枠)+スプレッドシート」の限界に対し、画面の完全なカスタマイズ性とリアルタイム性を得るためのインフラ投資として我慢する覚悟です笑。

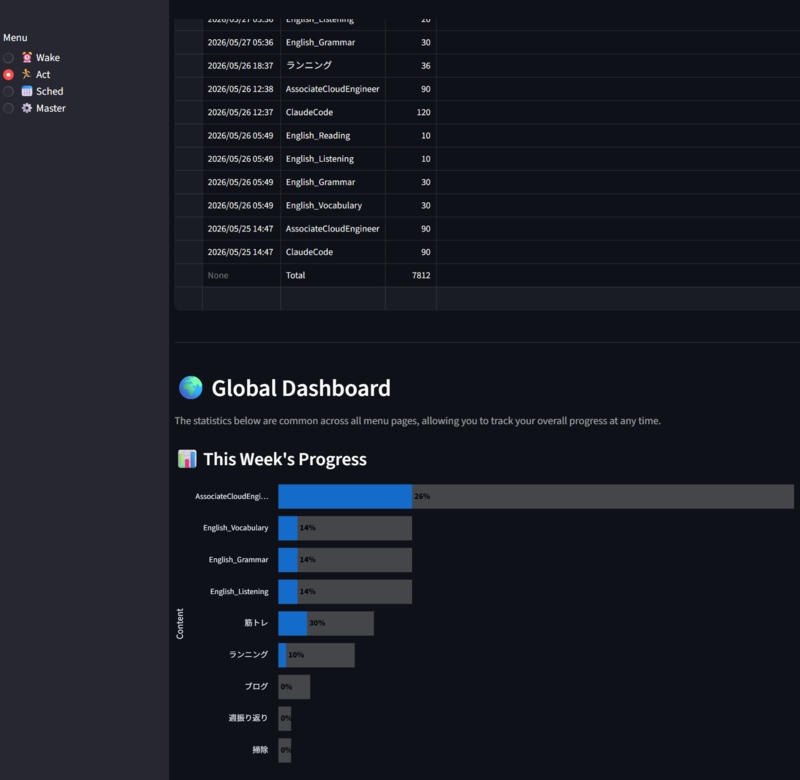
行動記録とグラフ進捗を同一画面に


5. 総括:課題の「仕組み化」と、次ステップ

今回の「Routine-Tracker」構築を通じて、資格知識の習得だけでなく、自分で作れるようになり一歩上達。また、現在は以下の2つで運用しています。

① GitHub Issue

運用の中で見つかった改善点や追加したい機能は、すべてGitHubのIssueに登録。 タスクを「イシュー(課題)」としてストックしておき、すきま時間で改修します。

② 次なるステップ:データ基盤の高度化(Cloud SQLへの移行検討)

BigQueryで作りましたが、日々のアプリケーション運用やリアルタイムなデータ処理を考慮すると、Cloud SQL(リレーショナルデータベース)への移行の方が良さそう、という新たな仮説も見えてきました。

今回「知識を得るだけでなく、実際に作ってみる」をしたからこそ、新しい課題やインフラ再選定の必要性、次のステップが見えてきました。今後も要件に合わせて少しずつプロダクトを改良していきます。

GCP Associate Cloud Engineer 合格 — 9週間・160時間の学習プロセス

Cloud RunやBigQueryを業務で使っていて、昨年CDL(Cloud Digital Leader)を取得してGCPの全体像は掴めましたが、実務でより活用するためにAssociate Cloud Engineer(ACE)に踏み切りました。

結果、9週間・約160時間で合格 🎉 本番は50問中不安な問題が3問だけ、50分余りで終了しました。

本記事では、どう工夫したのかの学習プロセスを書いていきます。

続きを読む

2026年上半期の振り返り

AI&機械学習の実務展開、基礎からの再挑戦

2026年も半分が経過しました。いつもどおり、半年間を振り返ります。

今年も新年江の島ランから開始


■■全体行動実績

朝活も仕組み化しつつ、この半年間も行動時間を積み重ねることができました。

項目 実績
計測期間 2026/01/01〜06/30
総行動時間 679.0 時間
ランニング走行距離 402.4 km
英語学習時間 236.8 時間

1. データ分析:統計知識の実務展開とCloud Codeで「3ヶ月から1週間」作業効率化

項目 投資時間(時間) 備考
統計検定2級 78.0 ※昨年分の108.8時間を加算すると、合計186.8時間(合格済)
ロジスティック回帰モデル開発 28.4
Webアプリ・CI/CD基盤構築 50.1
Cloud Codeによる業務効率化 74.2
合計 230.8 ※昨年分を含めた実質総投資時間は 339.6 時間

2025年末に掲げた「資格に拘らず、実務課題を解決するスキルを」という方針に沿っていきました。

ehrsp1.hatenablog.com

① 統計検定2級の取得と機械学習モデルの構築

昨年からの勉強を継続、2月に統計検定2級を取得。 「事象の要因分析」や「予測モデルの評価」など、3級取得時に比べていろいろ評価できるようになりました。

実務課題であるサービスユーザーの「解約(チャーン)」を事前検知に活かすことができました。

行動ログデータを用いPythonでロジスティック回帰モデルを構築。約30の変数の内使えそうな10の説明変数を利用し、解約確率の高いユーザーを特定。

実数は伏せますが、結果的に、解約確率の高いユーザーが、実際に解約につながったことも証明できました。

ロジスティック回帰は統計検定2級の範囲外のため追加での勉強でしたが、資格知識がないと到底できなかった、めちゃくちゃ実務に活きた取り組みになりました。

② Webアプリ化と自動デプロイ(CI/CD)基盤の構築

今後複雑なレポートやダッシュボードを作ることになるかも。ということでCloud内での自動化の仕組みを知っておきたい。

プライベートで使ってる行動管理アプリ(AppSheetとスプレッドシート)の、PythonのWEBアプリ制作を計画。

GitHubへのプッシュをトリガーにCloud Runへ自動デプロイされる基盤を実装・自動化。

かなりつまづきましたが、何とか完成。ホントにいろいろ勉強になりました。

③ Claude Codeの活用による自動化

4月後半からは、噂の「Claude Code」の学習にシフト。

実務で必要になり使ってみました。最初はいろんな方に資料をセットしていただきました。使ってみたところ、当初の作業工数約3ヶ月を見込んでいた作業を、1週間で完結しました。

なんじゃこの便利ツールは・・!と感動し参考書を1冊購入。

60時間かけて読破し、自業務(企画・分析・コーディング・資料作成)専用のテンプレを作成。 業務ごとにテンプレをコピペ⇒AIに聞かれたことに回答していけば、業務スケジュールやMTG結果からの軌道修正、必要に応じて資料やコードができあがります。

いくつかの業務で試行し、いろいろ効率化できました。まだまだ改善余地が多いですが、ポテンシャル高すぎる。

Claude Code恐るべし。

Claude Codeとの会話が急増


2. 英語学習:成長実感なき停滞、再度基礎からやり直し

データ関連は成長実感があったものの、英語はイマイチでした。

  • 英語学習の総投資時間: 計 236.8 時間(毎日平均90分) 
  • 202605のTOEIC結果: 530点(半年前より40点アップ)

2026年中にTOEIC650点を目指し、この半年間も淡々と勉強しましたが、5月のTOEICは厳しかった。

半年前と同じリスニングの音でつまずき、同じ問題数の長文問題の時間が足りないという成長の無さ。

「これだけ時間をかけて勉強しても、ほぼ成長しないのか」という絶望でした。

データ関係は楽しく勉強できてるんですが、本当に英語は集中力続かないし苦手。

苦しいですが、また軌道修正。長文対策へ進むのを再度ストップし、もう一度基礎の「文法と単語のやり直し」へ回帰します。

また、毎日20分のリスニング時間は維持しつつ、移動時間「ながら聞き」も取り入れて改善を計ります。


3. ランニング&筋トレ:体重増加への即応と、季節に合わせた自己管理

  • フィットネス関連の総投資時間: 計 69.0 時間
    • ランニング(走行距離):41.5 時間(402.4 km)
    • 筋力トレ:27.5 時間

上半期走行距離402.4km

2026年は「年間750km(前年比25%減)目標」へと下げました。(昨年は年間1000km走破目標)

毎週12km走ってましたが、上半期の途中で体重が増えてることに気が付く。。

これはマズイぞと、①②を考えました。

① ランニング:走量の引き上げ

太ったので、昨年同様に年間目標を1000kmに上げます。これでも太るならもう仕方がない笑

これから暑くなり、昨年はランニング距離を均等割にしていたので夏場がしんどかった経験から、配分は考えます。

② 筋トレ:強度の引き上げによる代謝コントロール

並行して、筋トレの強度も意図的に引き上げました。これで体を絞ります。


4. 「もこきま」の成果:「2時間」の執筆効率化

  • 振り返り・アウトプット関連の投資時間: 毎週約 60 分

2025年下半期から始めた、日々の行動を【目標】【行動】【気づき】【学び】で毎週の振り返り記録する手法「もこきま」。

勉強、ランニングなど各分野で、その時々に感じた感情の変化や行動内容をストックし続けて、ブログ制作にて活きました。

ehrsp1.hatenablog.com

これまで1記事の制作に約4時間かかっていましたが、約3時間へと短縮。

執筆プロセスの変化と効果

プロセス 所要時間 具体的な取り組みとメリット
初稿作成〜画像選定 1〜2時間 「もこきま」に書き溜めた記録をAIに投げるだけで、記事のベースがサクッと完成。⇒少し修正を加えて8割完成させる
推敲・ブラッシュアップ 残り時間 執筆内容を忘れかけた頃(1週間前など)に、何回か読み直して微修正を重ねる。

「もこきま」× AI が生んだ2つの真価

単に「早く書けるようになった」だけでなく、振り返りの深さも向上しました。

  • 一週間単位の「リアルな感情」のサルベージ

    後から書こうとすると絶対に忘れてしまう、その時々の「この経験が辛くてやり方を変えた」「ここは最高に楽しかった」という生々しい感情や気づきを思い出すことができます。

  • 効率化と「振り返りの厚み」の両立

    AIによる効率化で繰り返し読む時間が増え、自分の内面と向き合う時間も増しました。

効率的に、でも内省もしっかり。この流れが、現状イイ感じです。

早起きするとテンション上がる


■■ 2026年下半期への展望:基盤・基礎・基礎代謝

下半期は各領域の「基(ベース)」を作り込む期間とします。

領域 下半期のテーマ コアアクション
1. データ分析 【基盤】の構築 Google Cloudでのデータ基盤づくりへのシフト
2. 英語学習 【基礎】の徹底 急がば回れ。文法の基礎や短文のリスニングへの回帰
3. フィットネス 【基礎代謝】の向上 猛暑期の筋トレ特化と、秋からのランニング再加速

1. データ分析:予測モデルの先へ。データ「基盤」の構築

上半期はロジスティック回帰モデルを構築し、データから実際に予測する花形な業務をしました。

しかし、下半期は基盤側に目を向けてデータ基盤の構築に比重を置きます。

  • 次の一手: Google Cloudの各種サービスを組み合わせた、運用保守の仕組み化の実現。

  • スタンス: 目の前の分析業務も継続しつつ、「現場がよりデータを扱いやすくなる土台(基盤)」の構築。

2. 英語学習:「基礎固め」の徹底

TOEIC 650点クリアに向け、下半期は「急がば回れ」。

  • 文法・単語: 長文対策を一度ストップし、中学・高校レベルの文法という土台の再構築に集中。

  • リスニング: 移動時間の「ながら聞き」を徹底して耳を慣らす。

  • スタンス: 後半戦でのブレイクスルーを信じ、焦らず淡々とインプットを積み重ねます。

3. フィットネス:「筋トレメイン」へのシフト

年間走行距離1000km目標に変更。ただし昨年の経験から時期に合わせて距離を変えます。

  • 7月〜9月: 外ランのリスクを避け、室内での「筋トレメイン」にシフト。ウェイトの強度を上げて基礎代謝を引き上げ、とにかく体重を落とす!

  • 10月以降: ランニング量を一気に増やしてラストスパートをかけます。

おわりに:色々やり方は変えたけど、結局は「基本の徹底」がすべて

半年ごとに振り返りしてきましたが、行き着く本質はどれも同じですね。「資格を取ることの是非」や「データ基盤の優位性」を語ることはあまり意味がない。それは表面的な優劣の話。

「日々の基礎・基本をどれだけ積み上げられるか」でパフォーマンスが変わるんだな、と改めて痛感しています。

予測モデルを作るっていう華やかなアウトプットの裏には、泥臭いデータ基盤の支えがあるように。

英語でブレイクスルーを掴む裏には、地道な文法直しがあるように。

下半期、この泥臭い土台作りの重要さを理解した上で、全力で取り組みます!!